
Pythonの実務を最適化するyield活用術/ログ・CSV・API処理のストリーミング手法

数GBのログをリストに格納すると、メモリが足りず処理が停止する。
APIからデータを取得するコードも、ページを切り替えるループで複雑になる。
Pythonで大量のデータを処理する際、こうした問題に直面するケースは多々あります。
yieldなら、処理に合わせてデータを1件ずつ生成し、メモリの消費を抑えられます。
本記事ではreturnとの違いと基本文法を押さえ、
実務向けの3つの活用例や、yieldが適さない場面を見ていきます。
Contents
Pythonのyieldとは?returnとの違いは「終了」か「一時停止」か
関数内にyieldを記述すると、ジェネレータ関数になります。
ジェネレータは値を1つずつ生成するオブジェクトです。
値を返したところで処理を止め、次の値が要求されると停止した続きから再開します。
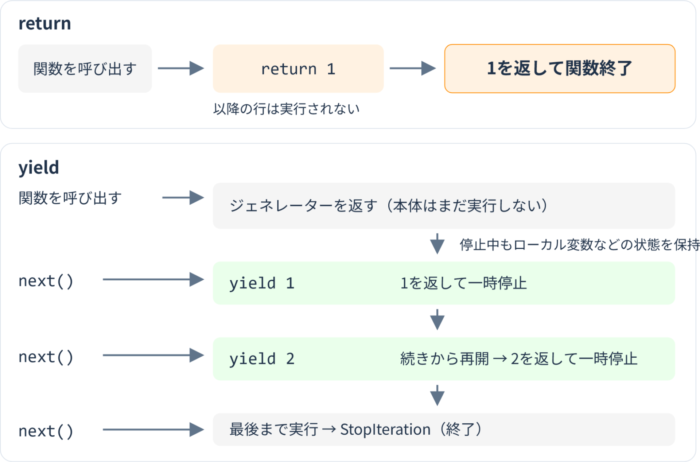
returnは関数を終了し、yieldは一時停止する【図解】
returnで値を返すと関数の実行は終わり、ローカル変数も破棄されます。
一方、yieldは関数の状態を残して実行を中断します。
ローカル変数も保持されるので、再開時にはその値を使って後続の処理を進められます。
| 通常の関数とジェネレータ関数の実行挙動 |
|---|
def return_function(): return 1 return 2 # この行は実行されない def yield_function(): yield 1 yield 2 # 2回目のnext()で実行される print(return_function()) # 1gen = yield_function() # 関数の呼び出しは1回だけprint(next(gen), next(gen)) # 1 2(同じジェネレータから順に取り出す) |
yieldを使うとメモリを節約できる理由|遅延評価の仕組み
リストでは全体の値をあらかじめ生成してメモリに格納しますが、ジェネレータが計算するのは要求された次の1つだけです。
必要な時点まで計算を先送りする方式を遅延評価といいます。
| リストとジェネレータのメモリ比較 |
|---|
import sys # 100万個の値で、リストとジェネレータのメモリ使用量を比べる numbers = [x for x in range(1_000_000)] # リスト内包表記gen_numbers = (x for x in range(1_000_000)) # ジェネレータ式([]ではなく()で囲む) print(sys.getsizeof(numbers)) # 8448728(約8MB)print(sys.getsizeof(gen_numbers)) # 200(約200バイト)# Python 3.14.7での計測値。バージョンや環境によって変わる# リストは、要素の整数オブジェクトの分のメモリも別に使う |
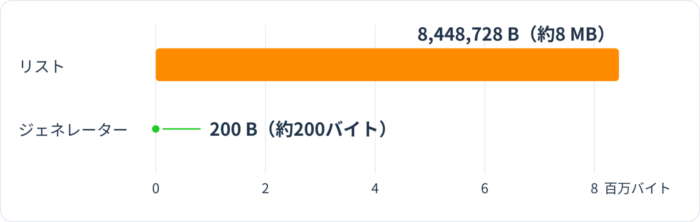
遅延評価により、繰り返しの回数が膨大になっても消費するメモリはほぼ一定で、処理を途中で打ち切った場合も無駄がありません。
| ジェネレータによる処理の遅延評価 |
|---|
def expensive_calculation(x): print(f”計算中: {x}”) # 実際に呼ばれたときだけ表示される return x * x def generate_squares(numbers): for num in numbers: yield expensive_calculation(num) squares = generate_squares([1, 2, 3, 4, 5]) # この時点では1つも計算しない for i, square in enumerate(squares): print(square) if i >= 1: break # 2つ取り出したら終了。3つ目以降は計算されない |
yieldの使い方|ジェネレータ関数の基本文法とイテレータの挙動
yieldの具体的な使い方を見ていきます。
ジェネレータ関数の作り方
defによる関数定義にyieldを含めると、ジェネレータ関数として動作します。
呼び出し時に返されるのはジェネレータオブジェクトで、本体の処理はまだ始まりません。
引数の受け取り方は通常の関数と同じです。
| ジェネレータを使った無限ループの処理 |
|---|
def count_up(start=0, step=1): current = start while True: # 無限ループでも、値はnext()で求めた分しか生成されない yield current current += step counter = count_up(1, 2) # 1から2ずつ増やす。この時点では関数本体は動かないprint(next(counter)) # 1print(next(counter)) # 3print(next(counter)) # 5 |
next()とfor文で値を取り出す方法|内部の挙動の違い
リストやrangeなど、for文で順に扱えるものをイテラブルといいます。
iter()に渡せば、next()で値を1つずつ取り出せるイテレータが得られます。
ジェネレータオブジェクトは、イテレータの一種です。
取り出せる値がなくなると、next()はStopIteration例外を送出します。
for文では内部でiter()を使い、next()を繰り返して値を取得し、StopIterationによってループを終了します。
ジェネレータの終了検知(StopIteration)とイテラブルの違い |
|---|
def countdown(n): while n > 0: yield n n -= 1 # for文で取り出すfor num in countdown(3): print(num) # 3, 2, 1 # 上のfor文は、内部で次のように動いているit = iter(countdown(3))while True: try: num = next(it) except StopIteration: # 値が尽きたらループを抜ける break print(num) # next()に既定値を渡すと、値が尽きても例外にならないgen = countdown(1)print(next(gen, None)) # 1print(next(gen, None)) # None # リストやrangeはイテラブルだが、イテレータではない# next(range(3)) → TypeError: ‘range’ object is not an iteratorprint(next(iter(range(3)))) # 0(iter()でイテレータにすれば取り出せる) |
yieldを実務で使う方法|3つの活用パターン
実務で利用する機会の多い3つの使い方を見ていきましょう。
大容量のログ・CSVファイルをメモリ不足を起こさずに読み込む方法
数GBのファイルをreadlines()などで全行リストに読み込むと、メモリ不足(OOM)を招きます。
その結果、MemoryErrorが起きるほか、プロセスが強制終了する場合もあります。
yieldを使えば、読み込み・絞り込み・整形をそれぞれ独立した関数にし、順につなぐ構成にできます。
yield で処理を繋ぐ:読み込み・フィルタ・変換のパイプライン |
|---|
def read_lines(path): with open(path, encoding=”utf-8″) as f: for line in f: # ファイルを1行ずつ読み込む yield line.rstrip(“\n”) def filter_errors(lines): for line in lines: if “ERROR” in line: # ERRORを含む行だけを通す yield line def to_records(lines): for line in lines: # 例: “2026-10-01 12:00:00 ERROR DB connection failed” date, time, level, message = line.split(” “, 3) yield {“date”: date, “time”: time, “message”: message} # 3つの処理をつなぐ。メモリ上に置かれるのは、処理中の1行分だけfor record in to_records(filter_errors(read_lines(“app.log”))): print(record) |
csv.readerは、ファイルオブジェクトと同様に1行ずつ読み取るイテレータとして動作します。
| パイプラインの起点となるCSVストリームの作成 |
|---|
import csvdef read_csv(path): with open(path, newline=””, encoding=”utf-8″) as f: for row in csv.DictReader(f): yield row # CSVは、1行ずつ辞書として受け取れる |
ただし、処理が速くなるわけではありません。
APIのページネーションを1つのジェネレータにまとめる方法
APIが大量のデータをページごとに分けて返す方式を、ページネーションと呼びます。
ページ送りのループをジェネレータ関数に収めれば、呼び出し側ではページを意識せずfor文で受け取れます。
取得処理と保存処理を分離でき、テストしやすくなります。
| 通信処理とデータ処理を分離するAPIストリーミング |
|---|
import requests def fetch_all(url, per_page=100): page = 1 while True: res = requests.get(url, params={“page”: page, “per_page”: per_page}, timeout=10) res.raise_for_status() items = res.json() if not items: # 空のページが返ったら終了 return for item in items: yield item # 1件ずつ呼び出し側へ渡す page += 1 # 呼び出し側は、ページの切り替えを意識しなくてよいfor user in fetch_all(“https://api.example.com/users”): save(user) # 保存処理は別の関数に任せる |
yield fromでサブジェネレータに処理を任せる方法
Python 3.3で加わったyield fromを使うと、別のジェネレータが生成する値を順番にそのまま返せます。
yield from によるジェネレータの結合 |
|---|
def read_all(paths): for path in paths: yield from read_lines(path) # 前述のread_lines()に読み込みを任せる # for line in read_lines(path): yield line と同じ動作 # 複数のログファイルを、1つのファイルのように扱えるfor line in filter_errors(read_all([“app1.log”, “app2.log”])): print(line) |
yieldを使わない方がよいケースは?リストとの使い分けと注意点
扱うデータの量や用途を考えると、リストを選ぶほうがよい場合もあります。
ランダムアクセスやソートが必要ならリストを使う
ジェネレータにはgen[0]のようなインデックスによる参照やlen()を使えず、値を一度取り出し終えると空になります。
また、sorted()は全要素を内部でリスト化するので、ソートする場合はメモリを節約できません。
小さなデータを繰り返し参照するならリスト、大きなデータを順に1回だけ処理するならジェネレータが適しています。データ量が少ない場合は、リストのほうが速いことも多くあります。
| ジェネレータの制約と速度面の注意点 |
|---|
gen = (x for x in range(3))print(list(gen)) # [0, 1, 2]print(list(gen)) # [](2回目は空になる)# gen[0] や len(gen) は TypeError になる # 1,000要素の合計を2万回計算した時間(Python 3.14.7実測値)# sum([x * 2 for x in range(1000)]) → 約0.39秒(リスト)# sum(x * 2 for x in range(1000)) → 約0.43秒(ジェネレータ) |
デバッグしにくさへの対策|型ヒントGeneratorの書き方
ジェネレータでは値の取得時にエラーが発生するので、原因を特定しにくい場合もあります。
ジェネレータを返す関数であることを明示的に型ヒントで示しておくとよいでしょう。
型ヒントはcollections.abcのGeneratorで記述します。
typing.Generatorは3.9以降、非推奨とされています。
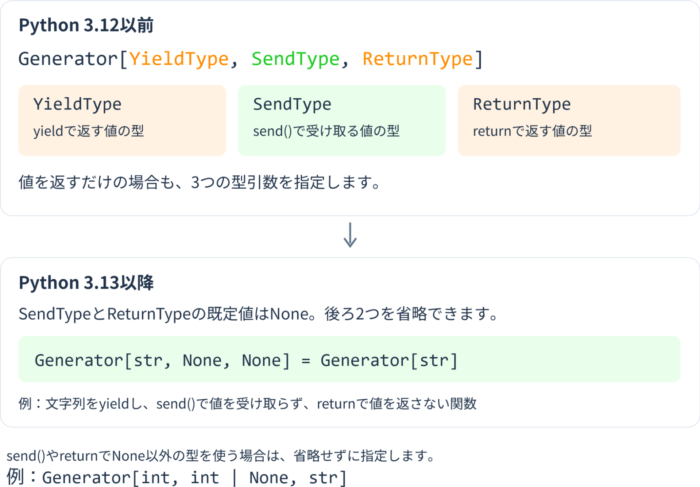
Python 3.13 以降のジェネレータ型ヒントの簡略化と Iterator の使い分け |
|---|
from collections.abc import Generator, Iterator # Generator[YieldType, SendType, ReturnType]# ※ Python 3.12までは3つとも指定が必要def running_total() -> Generator[int, int | None, str]: total = 0 while True: value = yield total # send()で送られた値を受け取る if value is None: return “done” total += value acc = running_total()next(acc) # 最初のyieldまで進める(0)print(acc.send(5)) # 5print(acc.send(3)) # 8 # Python 3.13以降は、SendTypeとReturnTypeを省略できる(既定値はNone)def read_lines(path: str) -> Generator[str]: “””ファイルを1行ずつ順番に読む。先頭から最後まで一度限り。””” with open(path, encoding=”utf-8″) as f: for line in f: yield line.rstrip(“\n”) # 値を返すだけなら、Iteratorでもよいdef count_up(start: int = 0, step: int = 1) -> Iterator[int]: current = start while True: yield current current += step |
yieldを活かせる開発環境とは?パフォーマンスにこだわれる職場の特徴
保守を主に担当する案件や、一部の工程だけを受け持つ職場では、性能の改善や設計の再検討に携われる機会が限られることもあります。
メモリ消費やパフォーマンスを考慮した設計が必要になりやすい職場は、
- ・自社サービスで大量のデータやトラフィックを処理する開発
- ・ログ分析や機械学習を支えるデータ基盤開発
- ・開発工程にコードレビューや静的解析を取り入れたチーム
などです。
自社サービスやデータ基盤を開発する際、コードレビューでジェネレータの採用理由を伝えられると、設計の力を評価してもらいやすくなります。
性能改善に関わる仕事なら、アールストーンのPython求人 など、職種検索をして参考にしてみてください。
まとめ|Pythonのスキルを活かして、もう一歩上の開発フェーズへ
Pythonのyieldを使えば、関数の実行を中断しつつ値を1つずつ生成でき、大量のデータをほぼ一定のメモリ使用量で扱えます。
大容量ファイルの読み込みやAPIのページネーションで活用できますが、繰り返し参照するデータにはリストを選ぶとよいでしょう。
大規模なデータの処理やパフォーマンスの改善に取り組みたい場合、yieldとリストを適切に選べる知識は転職でも強みになります。
Pythonの経験を活かせる職場を探す際は、アールストーンのPython求人をぜひ確認してみてください。